はじめに
 みなさん、こんにちは。プロダクト開発本部でインフラを担当している柳澤です。
前回の AWS Summit 探訪記 に続き、2026 年 7 月 30 日(木)・31 日(金)に東京ビッグサイトで開催された Google Cloud Next Tokyo '26 に参加してきましたので、その所感をお伝えします。
なお、昨今の酷暑のため2日目のみの参加で所感を執筆している点についてはご了承ください。
前回のブログをお読みいただいた方の中に奇跡的に記憶に残っておられる方もいらっしゃるかもしれませんが、AWS Summit の会場で私は、どこを向いても生成 AI・エージェントという空気に、若干食傷気味でした。
ところが今回の Next Tokyo は、同じように AI 一色の会場だったにもかかわらず、まったく違う体験になりました。展示や機能そのものが変わったからではありません。変わったのは、私が「課題」を携えて会場に入ったことでした。
今回はその「課題を持って参加する」という体験を軸に、Next Tokyo で何を見て、何を持ち帰ったのかを書いていきます。セッションの詳しいレポートというより、カンファレンスとの向き合い方が変わった話、として読んでいただけると幸いです。
結論から書いてしまうと、持って行った 3 つの問いは、それぞれ違う形で前に進みました。その「進み方の違い」も含めて書いていきます。
前回のAWS Summitでは油断してあまり写真を撮っていなかったので、今回は柳澤比3倍でお送りします。
今回は「課題」を持って行った
前回と今回で決定的に違ったのは、参加前の自分の状態です。
いま私は、社内の BigQuery(以降、BQ とします)の管理やデータ設計まわりの課題と日々向き合っています。
インフラを預かる立場から見て、コストの管理やデータセットの設計・整理に、大きな伸び代しかなく、これをどうにかしたいという明確な課題感を持って参加しました。
特にメインで利用しているデータセットをデータパイプラインごと作り直すための計画を作ろうとしていたため、なにかしらのヒントになるものを持ち帰るモチベーションが非常に高い状態でした。
もっとも、漠然と「課題感がある」だけでは、会場では何も起きません。実際に私が持って行ったのは、作り直しの計画を立てるうえで決めなければならない、次の 3 つの問いでした。
- 現在 AWS 側にあるデータを、どうやって Google Cloud の分析基盤に載せるのか
- BQ に次々と載ってくる AI 機能に、いま乗るべきなのか。それとも土台を整えるのが先なのか
- 作り直すパイプラインを、これまで通り Terraform などの IaC(Infrastructure as Code)で管理し続けるべきなのか
いずれも社内で議論はしていたものの、自分たちだけでは決め手を欠いていたものです。この 3 つを頭の片隅に置いた状態で、会場に入りました。
Next Tokyo が「AI エージェント」を全面に押し出したイベントであることは、参加前から分かっていました。前回の私なら、そこでまた「またAIか…」となっていたかもしれません。しかし今回は、会場のすべての情報が「これは、うちの BQ の課題を解決してくれるのか?」という一つのフィルターを通して入ってきました。
同じ AI 一色でも、自分の中に具体的な問いがあるだけで、聞こえ方がまるで違う。これが今回の一番の発見でした。
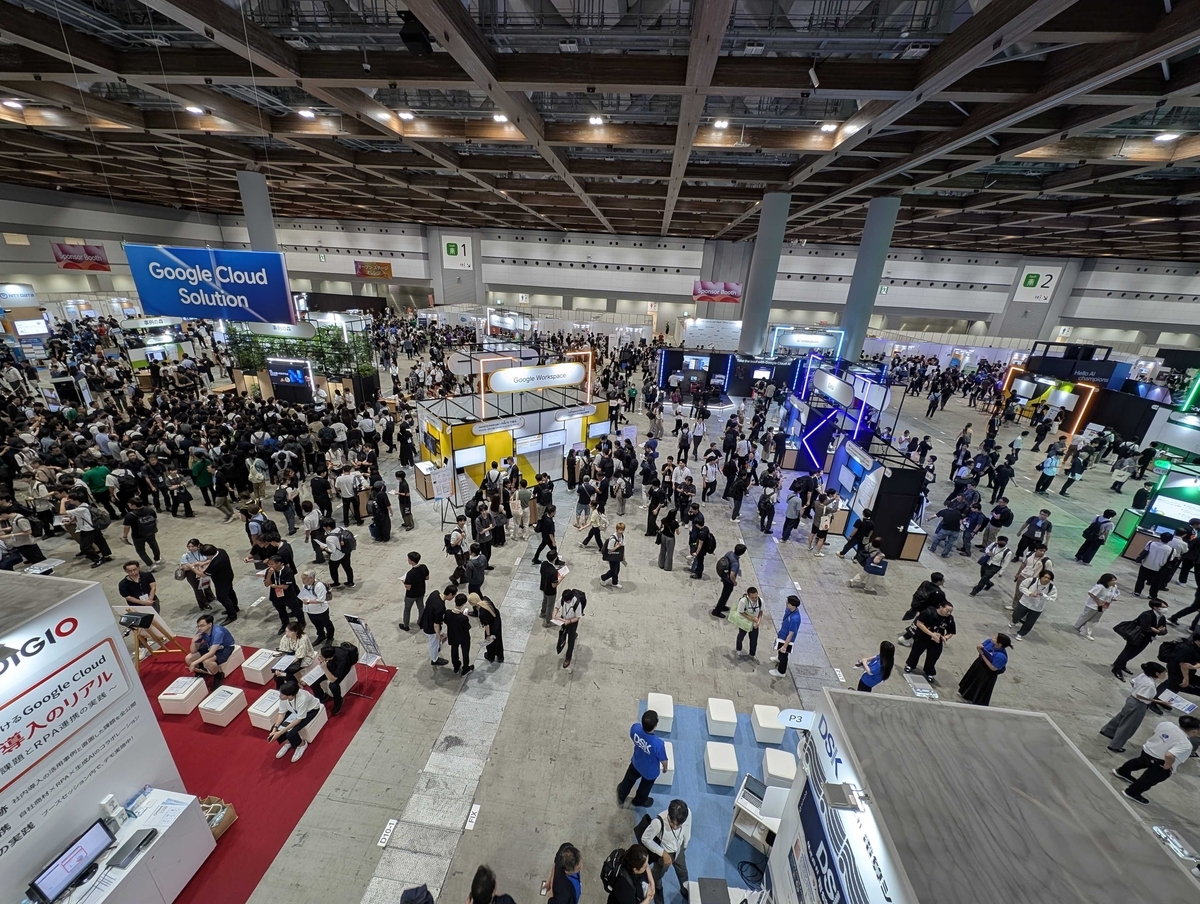
会場で ― 課題のフィルターでセッションを聞く
今回、"課題のフィルター" にはっきり刺さったのが、次のセッションでした。(ほかに 2 本聴いていますが、いずれも課題とは別筋だったので、おまけでまとめて触れます)
データ活用をより手軽に、効率よく!BigQuery を強化する AI エージェント
まさに今回の目的のド真ん中を狙って選んだセッションです。
BQ に組み込まれる AI エージェント群が、データに関わる 3 つの立場それぞれに向けて紹介されました。
| 対象 | エージェント | ひとことで言うと |
|---|---|---|
| ビジネスユーザー | AI アナリスト | SQL を書かずに自然言語でデータ探索・可視化。対話の文脈を保持した深掘りも可能 |
| データサイエンティスト | データサイエンス エージェント | ノートブック上で、データ探索からモデル構築・評価までを自然言語の指示で自律実行 |
| データエンジニア | データエンジニアリング エージェント | パイプラインの構築やレガシーコードのリファクタリングを支援。GUI とコードの双方向同期 |
このほか、感情分析やセマンティック検索が標準 SQL だけで完結する AI 関数の拡充も紹介され、「データを置く場所」だった DWH が「データが働く場所」へ変わりつつあることを実感しました。
特に当社ではPdM陣をはじめ(Looker Studio経由も含めて)日頃からBQを利用しているため、こういった関数が気軽に使えるというのは都度大掛かりな分析基盤を用意する必要がないという意味でも検討する余地は大きそうだなと思いました。
ただ、前回執筆した内容でもあるのですが、こうした機能を効果的に使うにしても、土台となるデータ基盤が整っていることが大前提となります。裏を返せば、基盤さえ整っていれば AI 機能には後からでも乗れる、ということでもあります。
これで、AI 機能にいま乗るべきか、それとも土台を整えるのが先か——という問いの答えははっきりしました。新機能を追いかけるより、土台の作り直しを先にやる。順序が決まったわけです。最新機能の話を聞きに行ったはずが、聞けば聞くほど「まず足元を固めろ」という結論に近づいていく、という体験でした 😇
課題を、その場でプロにぶつけてみた
今回いちばんの収穫は、抱えていた課題をその道のプロに直接ぶつけられたことでした。
Next Tokyo には、セッション登壇者に質問できる「Ask the Speaker」のコーナーや、Expo の各ブースに立つ製品エキスパートなど、プロに直接聞ける場がいくつも用意されています。
前回の AWS Summit を振り返ると、私はセッションを聴くだけで満足していました。質問しようにも、そもそも「聞きたいこと」が自分の中になかったのです。しかし今回は手元に具体的な課題があったので、話を聞いている最中から「これはうちの場合どうなるんだろう」という問いが自然と湧いてきて、その場でぶつけることができました。
Ask the Speaker ― 登壇者に 2 つ、ぶつけてみた
BQ のエージェントのセッション後、登壇者をつかまえて 2 つ質問しました。
一つは、ビジネスユーザー向けの「AI アナリスト」について。
SQL を書かずに自然言語でデータを探索・可視化できる機能ですが、これは既存の Looker Studio でも近いことができます。 両者は実際どう使い分けるべきか、と尋ねてみました。返ってきたのは「用途によっては Looker Studio で十分」という、案外あっさりした答え。AI を前面に押し出したセッションの登壇者自身が、既存ツールで足りる領域をきちんと線引きしてくれたのは、かえって信頼できる回答でした。
そしてこれは、どこまでを新しい仕組みに乗せ替えるか、という線引きの面でも効きました。全社に一律で広げるのではなく、Looker Studio で足りている用途はそのまま残す。そう線を引ければ、作り直しの対象範囲そのものを絞れます。
もう一つは、データエンジニア向けの「データエンジニアリング エージェント」について。
GUI でパイプラインを組めるようになると、これまで IaC で管理してきた世界と、どう棲み分け・管理していくべきか——正直、自分でも明確な答えを持てていなかった問いをぶつけました。返ってきたのは「今のところ確立した定石があるわけではなく、まずは試してみるのが早い」という趣旨の答えでした。
パイプラインを IaC で管理し続けるべきかという問いについて、この日はっきりした答えが得られたわけではありません。ただ、第一人者ですら手探りだと分かったことで、「外に正解を探しに行くフェーズではない」ということだけは確実になりました。であれば、小さく試して自分たちの判断材料を作るしかありません。答えが出なかったのではなく、次に何をすべきかが決まった。そういう種類の前進でした。
ただ正直に書くと、Ask the Speaker は長蛇の列ができていた関係で 1 人あたり 1〜2 分ほどで、腰を据えたディスカッションとまではいきませんでした。それでも、第一人者の"肌感"をその場で直接もらえる価値は大きいと思うので、聞きたいことができた方はぜひ列に足を運んでみるのもいいのではないかと思います。
ブースのエキスパートに相談 ― Borderless Lakehouse を見送るまで
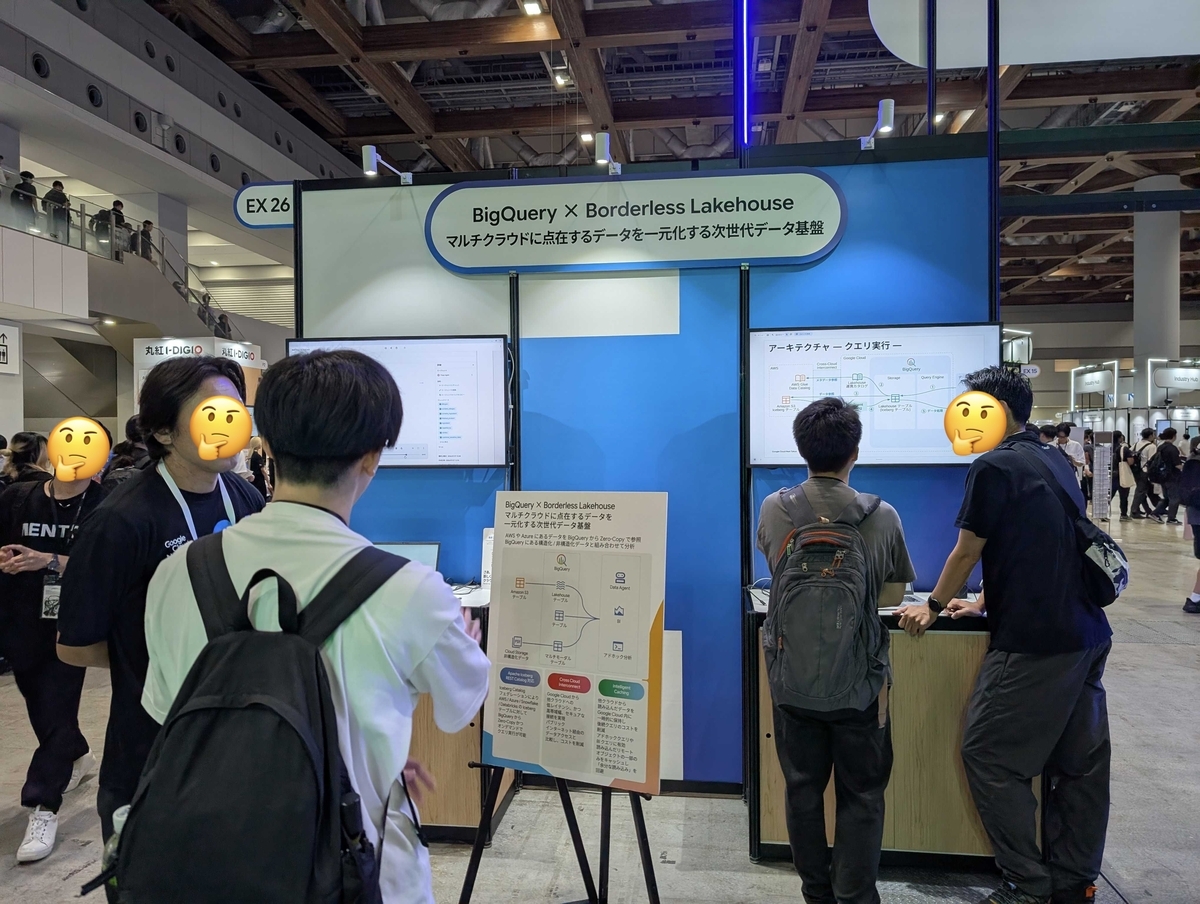
登壇者への質問が短い立ち話なら、こちらはじっくり相談できた一件です。Expo の展示ブースでは、製品ごとに立つエキスパートに、自分の構成を持ち込んで相談できます。私が足を止めたのは、Borderless Lakehouse のブースでした。
Borderless Lakehouse は、AWS など他クラウドに置いたデータを、ファイル移行や ETL パイプラインを組まずに、その場で BigQuery から直接クエリできる機能です。「データ本体は動かさず、計算だけを持っていく」という設計思想で、冒頭に挙げた「AWS 側のデータをどう分析基盤に載せるか」という問いに、ど真ん中で効きそうに見えました。
そこで、想定していた AWS と Google Cloud をまたぐ構成を、ブースのエキスパートにそのままぶつけてみたところ、返ってきたのは冷静な指摘でした。いわく、「AWS と Google Cloud の間の通信が多いユースケースでは、クロスクラウドのデータ転送(下り= egress)のコストが積み上がり、かえって割高になりやすい」。
持ち帰って裏を取っても、この指摘は的確でした。Borderless Lakehouse はデータ本体こそ動かしませんが、クロスクラウドの結合やクエリ結果の返送では実データの転送が発生し、その転送は課金対象です。通信量が増えるほどコストが効いてくる構造で、これを抑えるにはキャッシュや専用の相互接続(Cross-Cloud Interconnect)といった手立てが要りますが、後者は固定費を伴う投資で、恒常的かつ大規模な利用が前提になります。設計をこれから練る段階の私たちには、正直、重すぎました。
結果、この機能は「今回は見送り」と判断しました。でも、これこそ現地参加の価値だと感じています。カタログを眺めるだけなら「便利そう」で止まっていた機能を、エキスパートとの対話と持ち帰っての裏取りで、"自社には合わない" という判断にまで一気に落とせたのです。導入する判断だけでなく、導入しないと早く決められることも、立派な収穫でした。
3 つの問いは、どこまで進んだか
2 日目の半日で、持って行った 3 つの問いはこうなりました。
| 持って行った問い | 会場で得たもの | 帰ってからの現在地 |
|---|---|---|
| AWS のデータをどう載せるか | 転送コストが支配的になりやすい | Borderless Lakehouse は見送り |
| AI 機能に今すぐ乗るか | 土台が整っているのが大前提 | 作り直しを先行、と順序が確定 |
| パイプラインを IaC で管理するか | 定石はまだない、試すのが早い | 小さく検証し判断材料を自作する |
そして、登壇者への短い質問も、ブースでのじっくりした相談も、成立したのは「自分の中に課題があったから」でした。カンファレンスの一番の価値は、豪華なセッションそのものよりも、この"課題を直接ぶつけられる時間"なのかもしれない——そう思えたのが、今回いちばんの収穫でした。
おまけ
前回同様、本編に収まらなかった小ネタと、次回参加する方(と未来の自分)への Tips を残しておきます。
番外編:Cloud Run GPU のゼロスケール推論
BQ とは直接関係ないのですが、社内の別プロジェクトで Cloud Run 上の AI ワークロードを検証していたこともあり、その復習を兼ねて「Cloud Run GPU で実現するゼロスケール AI 推論」も聴いてきました。
リクエストが来たときだけ GPU 付きインスタンスが立ち上がり、使わないときはゼロにスケールする——「GPU は確保したら常時稼働」という常識を崩す話です。Next '26 では NVIDIA RTX PRO 6000(Blackwell)対応が GA となり、70B クラスのモデルまでサーバーレスで動かせるとのこと。散発的にしかリクエストの来ない推論ワークロードでは、「アイドル時のコストがゼロ」が効いてきそうだと感じました。
BigQuery は「データベース」カテゴリではありません
実は、今回もう 1 本「ここまでできる!最新機能と AI を活用した Google Cloud のマネージド データベースの運用術」というセッションを聴いていました。「BQ の運用の話も聞けるだろう」と踏んで選んだのですが、始まってみると BQ はほぼ登場しません。
Google Cloud の文脈で「データベース」と言えば Cloud SQL・AlloyDB・Spanner といったオペレーショナル データベースのことで、BQ は「データ分析(アナリティクス)」側の住人だったのです。このことに気づいたのが、セッションが始まってから、というのが今回のオチです…。
内容自体は Database Agents やマネージド MCP サーバーなど運用者として学びのあるものでしたが、"課題のフィルター" にはハマりませんでした。BQ 目当てでセッションを選ぶときは、タイトルの雰囲気ではなくカテゴリと概要文まで確認しましょう。
おわりに ― 「またAIか」から「このAIは、うちの課題をどう解決する?」へ
前回の AWS Summit のブログを、私は「"AI に任せない(られない)部分" をどうハンドリングしていくかが、我々の仕事」という言葉で締めました。この考えは今も変わっていません。
今回の学びは、同じ AI 一色のイベントでも具体的な課題を持って臨むと、AI は「バズワード」ではなく「自分の課題を解決するかもしれない道具」として見えてくる、ということでした。「またAIか…」と感じてしまったあの日の私に足りなかったのは、AI への興味ではなく、AI にぶつける課題の方だったのかもしれません。
もう一つ書き残しておきたいのは、「前進」の形は一つではなかった、ということです。3 つの問いのうち、明確な結論が出たのは 1 つだけでした。1 つは順序が決まっただけ、もう 1 つに至っては答えすら出ていません。それでも、どれも確かに前には進んでいます。やらないと早く決められること、何から手をつけるかが定まること、外に答えがないと分かること。カンファレンスから持ち帰れるものは、必ずしも「解決策」の形をしていないのだと思います。
カンファレンスへの現地参加には、時間もコストもかかります。だからこそ、「いま自分が困っていること」を、1 つでもいいので言語化して会場に行く。それだけでセッションの聞こえ方も、専門家との会話も、持ち帰れるものも大きく変わります。次回もまた、そのときの課題を携えて参加したいと思います。
採用について
askenではエンジニアを絶賛募集中です。
まずはカジュアルにお話しできればと思いますので、ぜひお気軽にご連絡ください!
